







UPS Sizing for Servers: VA vs Watts, Runtime and Battery Replacement
A UPS is judged entirely on a day it's never been tested. Two mistakes cause most failures: sizing...

كل نشاط تجاري لديه اشتراك في روبوت الدردشة، أو أداة لمعالجة المستندات، أو فريق يلصق بيانات سرية بصمت في ChatGPT، يدفع بالفعل مقابل الذكاء الاصطناعي - فقط لكل رمز مميز، إلى أجل غير مسمى، مع خروج بياناتهم من المبنى. يتزايد عدد الشركات التي تطرح السؤال البديهي التالي: هل يمكننا تشغيل هذا بأنفسنا؟
الإجابة، بالنسبة لمعظم الشركات الصغيرة والمتوسطة، هي نعم - وتُعد أجهزة الشركات المجددة واحدة من أكثر الطرق فعالية من حيث التكلفة لتحقيق ذلك. يمكن لخادم Dell PowerEdge أو HPE ProLiant المجهز بوحدة معالجة رسومات (GPU) تشغيل نماذج لغوية حديثة مفتوحة المصدر، وأتمتة المستندات، وإنشاء الصور بالكامل داخل المؤسسة، بدون فواتير لكل رمز مميز وبدون مغادرة أي بيانات لشبكتك.
يغطي هذا الدليل ما يتطلبه الذكاء الاصطناعي الداخلي بالفعل، وأي الخوادم المجددة يمكن أن تحمل وحدة معالجة رسومات (GPU)، وأي البطاقات هي خيارات واقعية، وكيف تتوافق الجدوى الاقتصادية مع الدفع مقابل الذكاء الاصطناعي السحابي كل شهر.

تتراكم اشتراكات الذكاء الاصطناعي السحابية وفواتير API بهدوء. يمكن لفريق من عشرة أشخاص مشغولين بسهولة إنفاق عدة مئات من الدولارات شهريًا على ChatGPT وClaude وأدوات الذكاء الاصطناعي المختلفة - وهذا الرقم ينمو مع ازدياد الاستخدام. تشغيل نموذج مفتوح المصدر على أجهزتك الخاصة يحول هذه التكلفة المتكررة إلى شراء أجهزة لمرة واحدة.
التكلفة هي جزء فقط من الصورة. المحرك الآخر هو التحكم:
الخوادم الداخلية ليست قرارًا شاملاً. تدير العديد من الشركات عمليات الاستدلال اليومية محليًا وتنتقل إلى واجهة برمجة تطبيقات سحابية فقط للوظائف الثقيلة العرضية - مما يحقق معظم الوفورات في التكاليف دون الحاجة إلى تحديد حجم الأجهزة لتلبية ذروة الطلب النادرة.
نعم — مع التوقعات الصحيحة. لن يقوم الخادم المجدد بتدريب نموذج رائد، ولن ينافس مجموعة H100 الجديدة. لكن هذا ليس ما تحتاجه معظم الشركات بالفعل. عبء العمل المهم للغالبية العظمى من الشركات الصغيرة والمتوسطة هو الاستدلال - تشغيل نموذج مدرب بالفعل للإجابة على الأسئلة، أو تلخيص المستندات، أو إنشاء استجابة - وليس تدريب نموذج من الصفر.
الاستدلال أقل تطلبًا بكثير من التدريب، وتعمل النماذج الحديثة مفتوحة المصدر (Llama، Mistral، Qwen، DeepSeek، وغيرها) بشكل مريح على وحدة معالجة رسومات احترافية واحدة. هذه الوحدة هي الجزء الوحيد من هذا البناء الذي ستشتريه جديدًا أو مستخدمًا قليلاً - لكن الخادم الذي يحملها، وذاكرة الوصول العشوائي (RAM)، ومحركات الأقراص، والهيكل، ووحدات تزويد الطاقة الاحتياطية، كل ذلك هو بالضبط ما يجعل خادم PowerEdge أو ProLiant المجدد يستحق قيمته، بجزء بسيط من سعر الخادم الجديد.
فكر في الأمر على أنه تقسيم للميزانية: أنفق حيث يهم (وحدة معالجة الرسومات وذاكرة الوصول العشوائي الكافية) ووفر في كل مكان آخر (هيكل 2U مجدد ومثبت مع موثوقية على مستوى الخادم وإدارة عن بعد مدمجة بالفعل).
لا يمكن لكل خادم رف أن يستوعب وحدة معالجة رسومات. قبل شراء بطاقة، يجب أن يستوفي الهيكل بعض المتطلبات:
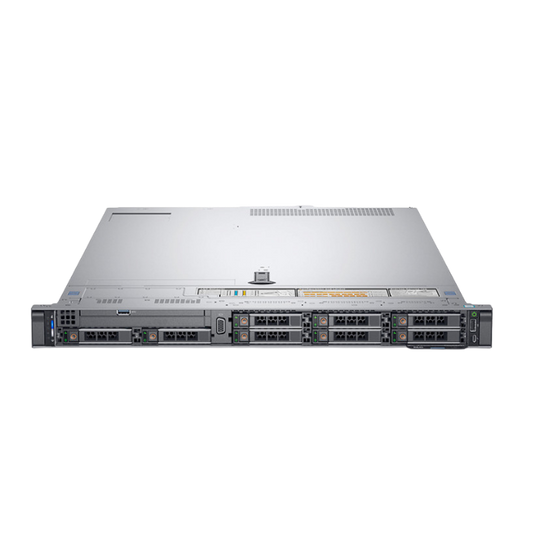
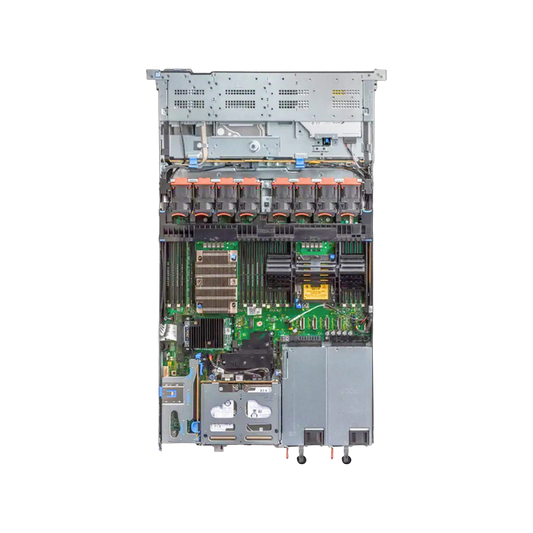
دعم وحدات معالجة الرسوميات ليس شاملاً عبر نطاقات PowerEdge و ProLiant - يعتمد ذلك على وجود فتحة رافع مناسبة في الهيكل، وتصميم تدفق الهواء، وتوصيل الطاقة. هذه هي النماذج التي تستحق الاستهداف في سوق الأجهزة المجددة:
| الخادم | سعة وحدة معالجة الرسوميات | ملاحظات |
|---|---|---|
| Dell PowerEdge R740 / R740xd | حتى 3 وحدات معالجة رسوميات مزدوجة العرض | أكثر مضيفات وحدات معالجة الرسوميات المجددة شيوعًا؛ يتطلب مجموعة تمكين وحدة معالجة الرسوميات، والرافع الصحيح، ووحدات تزويد طاقة بقوة 1100 واط أو أكثر |
| Dell PowerEdge R750 / R750xa | حتى 4 وحدات معالجة رسوميات مزدوجة العرض (R750xa) | R750xa مصمم خصيصًا للمسرعات؛ يدعم R750 القياسي بطاقات أقل وأصغر |
| HPE ProLiant DL380 Gen10 / Gen10 Plus | حتى 3 وحدات معالجة رسوميات حسب التكوين | خيار HPE شائع؛ تأكد من تضمين رافع جاهز لوحدة معالجة الرسوميات وخيار مروحة عالية الأداء |
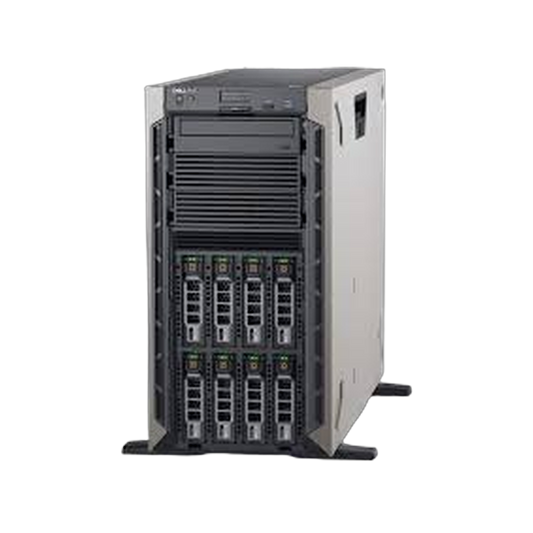
| Dell PowerEdge T440 / T640 (برج) | 1-2 وحدة معالجة رسوميات | خيار جيد للمكتب بدون رف — أكثر هدوءًا، ولكن بقدرة أقل لوحدة معالجة الرسوميات |
تأكد دائمًا من طراز وحدة معالجة الرسوميات المحدد مقابل قائمة الدعم الرسمية للخادم قبل الشراء - تنشر Dell و HPE قوائم توافق دقيقة، وقد يؤدي تشغيل بطاقة غير مدعومة (خاصة بطاقات GeForce/Radeon المخصصة للمستهلكين، والتي هي أطول من معظم قفص رافعات الخادم) إلى مشاكل في التبريد أو الطاقة أو التوافق المادي. عند الشك، اطلب منا تأكيد التوافق قبل طلبك.
ينقسم سوق وحدات معالجة الرسوميات بوضوح إلى فئتين لهذا الغرض، ويعتمد الخيار الصحيح على ميزانيتك ومدى "الإنتاج" الذي يجب أن يكون عليه النشر:
بطاقات مراكز البيانات (NVIDIA A2, A10, A16, A30, A40, A100)
مدعومة رسميًا في قوائم توافق Dell/HPE، مبردة بشكل سلبي بواسطة تدفق هواء الهيكل، مصممة للاستخدام في الرف على مدار الساعة طوال أيام الأسبوع. الخيار الآمن والمدعوم لنشر الأعمال.
بطاقات المستهلك / المحترفين (RTX 4090, RTX A4000/A5000)
أرخص بكثير لكل جيجابايت من VRAM وشائعة في مجتمع Homelab، ولكنها مبردة بشكل نشط، وأطول مما تتوقعه رافعات الخادم، ونادرًا ما تكون في قوائم الدعم الرسمية - قابلة للتشغيل، ولكنها غير مدعومة.
تعد ذاكرة الوصول العشوائي للفيديو (VRAM) هي الرقم الذي يحدد النماذج التي يمكنك تشغيلها بالفعل - إنها العامل الأكبر الوحيد في تحديد الحجم، وأكثر أهمية من سرعة وحدة معالجة الرسوميات الخام. كدليل تقريبي للنماذج مفتوحة المصدر الكمية (المضغوطة):
| حجم النموذج | ذاكرة الوصول العشوائي للفيديو (VRAM) المطلوبة عادةً (الكمية) | مثال على حالة الاستخدام |
|---|---|---|
| 7–8 مليار معلمة | 8–12 جيجابايت | مساعد دردشة، صياغة، أسئلة وأجوبة وثائقية بسيطة لفريق صغير |
| 13–34 مليار معلمة | 16–24 جيجابايت | استنتاج عالي الجودة، مساعدة في البرمجة، RAG عبر وثائق الشركة |
| 70 مليار معلمة | 40–48 جيجابايت (أو وحدات معالجة رسوميات متعددة) | خادم ذكاء اصطناعي للفريق بمستوى إنتاجي، أعباء عمل أكثر تطلبًا |
بالنسبة لمعظم حالات استخدام الشركات الصغيرة والمتوسطة - مساعد دردشة داخلي، تلخيص المستندات، صياغة دعم العملاء - تكفي بطاقة مركز بيانات واحدة بسعة 16-24 جيجابايت في R740 أو DL380 مجدد. احتفظ ببنى وحدات معالجة الرسوميات المتعددة عندما يكون لديك بالفعل عبء عمل ثقيل ومثبت.
إذا كنت تقوم بالفعل بتشغيل Proxmox - بما في ذلك على خادم تم ترحيله في دليل ترحيل VMware إلى Proxmox الخاص بنا - فإن إضافة مضيف وحدة معالجة رسومات (GPU) إلى المجموعة أمر بسيط. يدعم Proxmox تمرير وحدة معالجة الرسومات (GPU passthrough) الكامل: يتم تسليم وحدة معالجة الرسومات مباشرة إلى جهاز افتراضي واحد عبر VFIO، مما يمنح هذا الجهاز الافتراضي أداء وحدة معالجة الرسومات شبه الأصلي، بمعزل عن بقية المجموعة.
الإعداد العملي، في لمحة:
يخصص التمرير القياسي وحدة معالجة الرسومات لجهاز افتراضي واحد في كل مرة - وهو أمر جيد لمضيف ذكاء اصطناعي واحد. إذا كنت بحاجة إلى مشاركة وحدة معالجة رسومات واحدة عبر أجهزة افتراضية متعددة، فإن ذلك يتطلب NVIDIA vGPU، والذي يحتاج إلى بطاقة مركز بيانات مرخصة لـ vGPU وترخيص إضافي، وهو مشروع أكبر مما تحتاجه معظم عمليات نشر الشركات الصغيرة والمتوسطة.
الأجهزة ليست سوى نصف المشروع. على الجانب البرمجي، تغطي أداتان تقريبًا جميع حالات استخدام الشركات الصغيرة والمتوسطة:
بالإضافة إلى أي منهما، توفر واجهة أمامية مثل Open WebUI لفريقك واجهة دردشة مألوفة، وتدعم كلتا الأداتين التوليد المعزز بالاسترجاع (RAG) - لتغذية النموذج بوثائق شركتك الخاصة بحيث تستند الإجابات إلى سياساتك أو عقودك أو قاعدة معارفك الفعلية بدلاً من التدريب العام للنموذج.
تعتمد نقطة التعادل كليًا على الاستخدام. يتم تسعير واجهة برمجة تطبيقات الذكاء الاصطناعي السحابية لكل رمز مميز، لذلك تتناسب التكلفة مباشرة مع الحجم - وهو أمر مناسب للاستخدام العرضي أو غير المتوقع. أما الأجهزة المملوكة فلها تكلفة ثابتة بغض النظر عن مدى عملها، وهذا ما يجعلها جذابة للاستخدام اليومي الثابت.
| واجهات برمجة تطبيقات الذكاء الاصطناعي السحابية | خادم وحدة معالجة الرسوميات (GPU) المحلي | |
|---|---|---|
| هيكل التكلفة | لكل رمز مميز، يتناسب مع الاستخدام | تكلفة شراء الأجهزة لمرة واحدة، ثم ثابتة إلى حد كبير |
| البيانات | تغادر شبكتك إلى طرف ثالث | لا تغادر منشأتك أبدًا |
| الأفضل لـ | الاستخدام الخفيف أو غير المتوقع أو العرضي | الاستخدام اليومي الثابت من قبل فريق، البيانات الحساسة |
| التوسع | فوري، لا حاجة لتخطيط الأجهزة | يتطلب شراء المزيد من وحدات معالجة الرسوميات/سعة الأجهزة الزائدة مقدمًا |
قاعدة إرشادية مفيدة من الصناعة: بمجرد أن يتجاوز استخدام وحدة معالجة الرسوميات (GPU) باستمرار حوالي 20%، تميل الأجهزة المملوكة إلى تحقيق نقطة التعادل مقابل أسعار واجهة برمجة تطبيقات السحابة في غضون 6-12 شهرًا. أقل من ذلك، بالنسبة لأعباء العمل العرضية أو المتقطعة، لا تزال السحابة عادةً أرخص — وهذا هو بالضبط السبب في أن النهج المختلط (محلي للاستخدام اليومي، سحابة للاندفاعات العرضية) يعمل جيدًا للعديد من الشركات الصغيرة والمتوسطة.
| الإعداد | التكوين | مناسب لـ |
|---|---|---|
| مضيف الذكاء الاصطناعي للفريق المبتدئ | R740 مجدد، 1x وحدة معالجة رسوميات بمركز بيانات 16-24 جيجابايت، 128 جيجابايت ذاكرة وصول عشوائي (RAM)، تخزين NVMe للإقلاع/النماذج | مساعد دردشة داخلي، أسئلة وأجوبة للمستندات، صياغة لفريق من 5 إلى 20 شخصًا |
| مضيف الأعمال المتنامية | R750xa / DL380 Gen10 Plus مجدد، 1-2x وحدات معالجة رسوميات 40 جيجابايت+، 256 جيجابايت ذاكرة وصول عشوائي (RAM) | نماذج أكبر، المزيد من المستخدمين المتزامنين، خطوط أنابيب RAG للإنتاج |
فيزيائيًا، في بعض الأحيان - لكن نادرًا ما يكون مناسبًا تمامًا. بطاقات المستهلك تبرد بشكل نشط، وغالبًا ما تكون طويلة جدًا بالنسبة لقارئ بطاقات التوسعة في الخادم، وليست مدرجة في قوائم التوافق الرسمية لشركة Dell أو HPE. يمكن أن تعمل في بيئة منزلية، ولكن بالنسبة للنشر التجاري، فإن بطاقة مركز بيانات مدعومة هي الخيار الأكثر أمانًا وقابلية للتنبؤ.
ليس لمعظم حالات الاستخدام في الشركات الصغيرة والمتوسطة. يمكن لوحدة معالجة رسوميات (GPU) واحدة لمركز بيانات بسعة 16-24 جيجابايت التعامل بسهولة مع نماذج المعلمات من 7B إلى 34B التي تغطي غالبية مهام الذكاء الاصطناعي للأعمال. بنيات وحدات معالجة الرسوميات المتعددة مخصصة للنماذج الأكبر أو العديد من المستخدمين المتزامنين - يستحق إضافتها بمجرد أن يكون لديك حاجة مؤكدة، وليس قبل ذلك.
نعم. يمكن أن يكون خادم وحدة معالجة الرسوميات (GPU) عقدة إضافية في بيئة Proxmox أو VMware موجودة، مع تمرير وحدة معالجة الرسوميات إلى جهاز افتراضي مخصص بينما يستمر باقي الكتلة في العمل بشكل طبيعي.
نادرًا، وعادة ما يكون غير ضروري. تعديل نموذج صغير بناءً على بياناتك الخاصة ممكن أحيانًا على وحدة معالجة رسوميات (GPU) قوية واحدة، لكن تدريب نموذج من الصفر يتطلب أجهزة تتجاوز هذا النطاق بكثير. تأتي جميع قيم الشركات الصغيرة والمتوسطة تقريبًا من الاستنتاج على نموذج مفتوح المصدر موجود - وليس تدريب نموذج جديد.
لقد انتقل الذكاء الاصطناعي المحلي من كونه تجريبيًا إلى تيار سائد أسرع مما توقعه أي شخص تقريبًا. بالنسبة للأعمال التي تدفع بالفعل بانتظام مقابل أدوات الذكاء الاصطناعي السحابية، يقدم الخادم المجدد المزود بوحدة معالجة رسوميات (GPU) طريقة مباشرة لجلب هذه التكلفة داخليًا — مع الحفاظ على البيانات الحساسة داخل الشركة طوال الوقت.
الصيغة: R740 أو R750xa أو DL380 مجدد مع مجموعة تمكين وحدة معالجة الرسوميات، ووحدة معالجة رسوميات لمركز بيانات مدعومة بحجم نماذجك، وذاكرة وصول عشوائي (RAM) كافية، وتخزين NVMe - تشغيل Ollama أو vLLM، بشكل مستقل أو كجهاز افتراضي مُمرر داخل مجموعة Proxmox موجودة.
في ServerDove Trading & Services، نوفر خوادم Dell PowerEdge و HPE ProLiant المجددة الجاهزة لوحدة معالجة الرسوميات في قطر — مجهزة بمُوسع البطاقات الصحيح، ومجموعة التمكين، ووحدات تزويد الطاقة، والتبريد لوحدة معالجة الرسوميات التي تختارها، بالإضافة إلى وحدات معالجة الرسوميات لمركز البيانات المتوافقة، وذاكرة الوصول العشوائي (RAM)، وتخزين NVMe. اتصل بنا وسنساعدك في تحديد حجم مضيف وحدة معالجة الرسوميات لعبء عمل الذكاء الاصطناعي الخاص بك.
A UPS is judged entirely on a day it's never been tested. Two mistakes cause most failures: sizing...
Every PowerEdge has iDRAC, every ProLiant has iLO — and the brand matters far less than most buyers...
Buying the biggest power supply available is the instinct — and it's the wrong one. PSU efficiency peaks...

